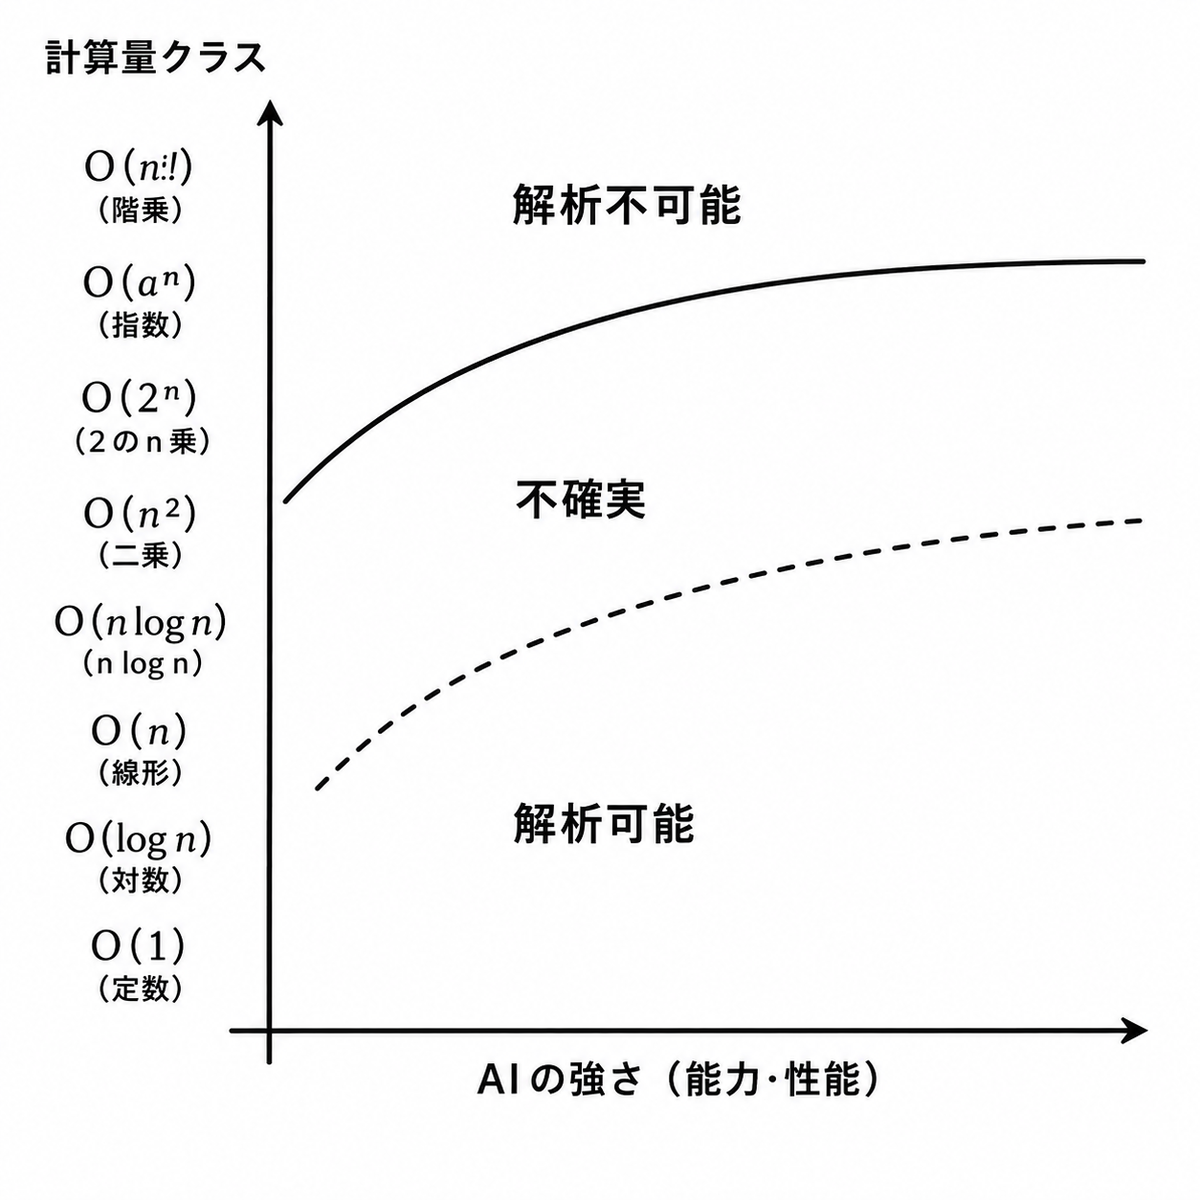
さて、リファクタリングについて、Epiplexity 構造抽出性という概念で考えると良いのではないか?という話を前回 、前々回 としてきた。
構造抽出性とはソースコードを見た際に、ここではどういう仕組みで何をしようとしているのか?といった情報を掴みやすいかどうかといった概念だった。従来よりEntropy情報量という概念があったが、実際のAIのような有限の計算資源の存在にとっては理想論すぎ、「実際に抽出可能な情報」というものについて考える必要があるというものだった。
この概念を考えるために、敢えて逆を考えてみよう。つまり、外部から見た振る舞いを変えずに、コードを理解しにくくするとどうなるか。何が起きるのか。
デファクタリング :外部から見たときの振る舞いを保ちつつ、理解や修正が困難 になるように、ソフトウェアの内部構造を変化させること
リファクタリングの逆の操作をデファクタリング と呼ぼう。デファクタリングをやることで何が起きるのか
リファクタリング不可能点
構造抽出性が悪いとはどういうコードだろうか。一例としてグローバル変数のようなモノが挙げられる。局所変数は、その変数が局所的であることが保証されるが、広いスコープから参照・更新できるグローバル変数があると、変数がどのように変わるのか状態遷移を考えるにあたって、まさに組み合わせ爆発的なケースについて考慮を必要とする。
実際には局所変数Aと局所変数Bのように振舞うのだとしても、これらをまとめてグローバル変数Gとしたとしよう。このグローバル変数GをリファクタリングしてAとBに分離するためには、Gを参照・更新する箇所を網羅的に調べて、A・Bが混ざっていない、二つの独立した変数に置き換えうるということを確認しなくてはならない。これはとても困難な作業だ。
これがA・Bのふたつの変数ならまだ良いが、これを変数C・D・E……と掛け合わせていくと、まさに構造を把握するために指数関数的な組み合わせ爆発を考慮しなくては真の構造を見出すことができなくなる。これがデファクタリングの一例だ。
混ぜるのは簡単だが、分離するには全体を把握する必要がある。ここに計算量の非対称性があるわけだ。
構造を抽出するために必要となる計算量のクラスという概念を考えることが出来る。例えばオーダー記法でいう O(2^n) となる状態組み合わせを網羅的に確認する必要がある構造抽出性、といったように。デファクタリングによって計算量クラスがより発散しやすくなるようにすると何が起きるか?
組み合わせ爆発により現実的な計算資源では構造を把握できなくなる 。
ある計算資源で現実的な時間で解析可能かどうかに線を引くことが出来、O(2^n) クラスの構造抽出性で、nがある程度大きいともう計算不可能だろう、構造を解析して掴むことが出来ないだろう、というリファクタリング不可能点が現れる 。
この計算不可能性は組み合わせ爆発 によるものだ。
VIDEO www.youtube.com
このリファクタリング不可能点に達したコードは、文字通りリファクタリング不可能で、ここに陥ったコードはたかだかコンピュータの性能が数桁向上した程度では手に負えないシロモノとなる。人間でも手に負えないが、コンピュータを用いても手に負えない。鍵をなくした暗号化されたデータのようなどうしようもない塊 になる。
このようなモノが存在しうるということは重要な示唆だ。ここに陥ったかのように見えるレガシーコードはあなたの周囲に存在しないだろうか?そのようなコードは、この先の未来にAIが強力になっていくとしても救えないことが示唆される 。
現代の現実的なコードの構造抽出性
構造抽出性クラスを考えることで、どうやらリファクタリング不可能なコードという概念がありそうだということを示した。
では、我々が現代にAIを使ったりしつつ生産しているソースコードというのはリファクタリング不可能点に陥るのだろうか?
おそらく、これはかなり可能性は低いのではないか。AIが生成するコードは現代の知見に基づき相応に可読性の高い、保守性の良いコードであるということ。構造抽出性がもとよりそれなりに高いだろうとみている。
しかし、AI生成によって規模が際限なく拡大していくと、システム全体では構造抽出性が下がって全貌は理解不能に陥るかもしれない。
これを防ぐには、結局のところ、パーツ単位で構造抽出性を高める、従来からの複雑性緩和の工夫を随時やっていくということになるだろう。
決定的に構造抽出性を低くする諸悪の根源、プログラミングにおけるタブー的なモノは、1960年代後半のソフトウェア危機 の頃に既に人類はすでに直面し、闘い、討伐してきたのではないか。故に我々はソフトウェアを現代の規模にまで巨大化させることが出来ているのではないか。
それは無軌道なgotoの乱用で生じるスパゲティのような処理フローであったり、メモリ空間を分けず状態遷移の把握を困難にする可変グローバル変数のようなものであったり。そういうものを我々は討伐してきたはずだ。
難読化という可能性
デファクタリングという操作を考えることで、組み合わせ爆発によるリファクタリング不可能点の存在を示唆したわけだが、ここで構造抽出性を下げる難読化の変換は、難読化されたコードを読み解きリファクタリングして構造抽出性を上げるよりもたやすい。
これは暗号化はたやすいが、その暗号化されたデータの暗号を破って復号化することは困難であることに類する。
デファクタリング操作によってAIをもってしても構造が分析不可能で、しかし、実行動作させることが可能な関数というものを作りうるのではないか。
まとめ
計算資源的に構造の抽出が不可能となり、リファクタリングができなくなる点をリファクタリング不可能点 と定めた。
レガシーコードにはリファクタリング不可能点を超えたモノが存在する可能性がある。こうなるとAIの発展とは関係なく、そのコードはもうリファクタリングが不可能である。
ただし、現代のAIを補助的に使うような開発では容易にそのリファクタリング不可能点を超えることはないのではないか。
1960年代後半に言われたソフトウェア危機はまさにこのリファクタリング不可能点の話だったのではないか。当時に整備された構造化プログラミングなどの技法は、リファクタリング不可能点を遠ざけるための重要な基礎となっているのではないか。
逆説的にそうした技法を逆用することでデファクタリングが行えるのではないか。デファクタリングにより構造の抽出が不可能なコードを意図的に創り出すことができるのではないか。
次回、試験性と検証可能性
おまけ
過去に リファクタリングの事象の地平線 という記事を書いている。この時は経験則として大きなステップでリファクタリングをしなくてはいけない状態に陥るとリファクタリング不可能になるといったことを語っていたが、この「リファクタリング不可能」を本稿ではもう少し具体的に示せたのではないか。
追記
8/23追記。簡単にだが、実験を行った。
関数hoge(int)に対するデファクタリングをAIによって行いhoge2(int)を作成し、同じAIによって解析させる、hoge2(int)を更にデファクタリングをさせhoge2(int)を解析される、hoge3、hoge4……として6段階まで試みた。
感触としては、かなり長大で複雑な人間には解読困難なコードが生成されたものの、AIによっては解析が行えた。これが示唆するのは、並の人間の営みによるスパゲティに対しては現代のAIは十分な解析能力をもっており、コードそのものの解釈という点ではリファクタリング不可能点は遠そうに見える。
つまり、過去のレガシーコードが偶発的にリファクタリング不可能点を超えているのではないか?という可能性を危惧していたわけだが、ロジックの複雑さ起因のリファクタリング不可能点はそう簡単には超えなさそう。
現実のシステム開発においてリファクタリング不可能点が登場するのは、コードの複雑さよりも、コードと業務の対応付けの部分の情報欠損によるところが大きいのではないか。
AIは複雑なロジックであれ、ソースコードという確定的な事象にはかなり強い。しかし業務の想定のような部分になると不確実さは確実に残り、推定は大きく外すように思える。
となると、ロジック事態を綺麗にすることよりも、JavaDocに契約プログラミングの契約を明示することに力を割く方が労力を投資する方が有益なのではないかと思える。
悪意溢れる難読化コード
public String hoge_6 (int i) {int a0 = i ^ (i << 3 ) ^ (i >>> 2 );int a1 = a0 ^ a0;int a2 = (a1 | -a1) >>> 31 ;int [] a3 = {6 - 3 ,10 / 2 ,2 << 1 ,21 / 3 ,3 * 3 ,22 - 11 ,7 + 6 ,1 ) & 1 ) + 16 ,38 >>> 1 ,23 ,29 ,31 };int [][] a4 = new int [a3.length ][10 ];for (int a5 = 0 ; a5 < a3.length ; a5++) {int a6 = a3[a5];int a7 = i / a6;int a8 = a7 * a6;int a9 = i ^ a8;int b0 = ((a9 | -a9) >>> 31 ) ^ 1 ;int b1 = ((a6 ^ 3 ) | -(a6 ^ 3 )) >>> 31 ;int b2 = ((a6 ^ 5 ) | -(a6 ^ 5 )) >>> 31 ;int b3 = ((a6 ^ 4 ) | -(a6 ^ 4 )) >>> 31 ;int b4 = ((a6 ^ 7 ) | -(a6 ^ 7 )) >>> 31 ;int b5 = ((a6 ^ 9 ) | -(a6 ^ 9 )) >>> 31 ;int b6 = ((a6 ^ 11 ) | -(a6 ^ 11 )) >>> 31 ;int b7 = ((a6 ^ 13 ) | -(a6 ^ 13 )) >>> 31 ;int b8 = ((a6 ^ 17 ) | -(a6 ^ 17 )) >>> 31 ;0 ] = b0 & (b1 ^ 1 );1 ] = b0 & (b2 ^ 1 );2 ] = b0 & (b3 ^ 1 );3 ] = b0 & (b4 ^ 1 );4 ] = b0 & (b5 ^ 1 );5 ] = b0 & (b6 ^ 1 );6 ] = b0 & (b7 ^ 1 );7 ] = b0 & (b8 ^ 1 );8 ] = (a4[a5][2 ] ^ a4[a5][2 ]) | (a4[a5][3 ] & 0 ) | (a4[a5][4 ] & 0 );9 ] = ((a4[a5][5 ] | a4[a5][6 ] | a4[a5][7 ]) & a2);int c0 = 0 ;int c1 = 0 ;int c2 = 0 ;int c3 = 0 ;for (int c4 = 0 ; c4 < a4.length ; c4++) {0 ];1 ];8 ];9 ];int [] c5 = new int [32 ];0 ] = c0;1 ] = c1;2 ] = c0 ^ c1;3 ] = c0 & c1;4 ] = c0 | c1;5 ] = (c5[4 ] ^ c5[2 ]) ^ c5[3 ];6 ] = ((c5[5 ] | -c5[5 ]) >>> 31 );7 ] = c2;8 ] = c3;9 ] = c5[7 ] ^ c5[7 ];10 ] = c5[8 ] & c5[9 ];11 ] = (c5[0 ] & c5[10 ]) | (c5[1 ] & c5[10 ]);12 ] = ((i + c5[11 ]) ^ (c5[11 ] + i));13 ] = ((c5[12 ] | -c5[12 ]) >>> 31 ) ^ 1 ;14 ] = c5[13 ] & 1 ;15 ] = c5[14 ] ^ 1 ;16 ] = c5[15 ] & 0 ;17 ] = c5[16 ] ^ c5[16 ];18 ] = (c5[2 ] & c5[17 ]) | (c5[3 ] & 0 );19 ] = ((c5[18 ] | -c5[18 ]) >>> 31 );20 ] = c5[19 ] ^ c5[19 ];21 ] = (c5[0 ] | c5[20 ]) ^ c5[20 ];22 ] = (c5[1 ] | c5[20 ]) ^ c5[20 ];23 ] = c5[21 ] ^ c5[0 ];24 ] = c5[22 ] ^ c5[1 ];25 ] = c5[23 ] | c5[24 ];26 ] = c5[25 ] & 0 ;27 ] = ((i ^ i) | c5[26 ]);28 ] = ((i + 2 ) ^ (2 + i));29 ] = c5[28 ] | c5[27 ];30 ] = ((c5[29 ] | -c5[29 ]) >>> 31 ) ^ 1 ;31 ] = c5[30 ] & 1 ;int [] d0 = {9 ],10 ],17 ],18 ],20 ],26 ],27 ],29 ],20 ]) | (c1 & c5[20 ]),0 ,0 ,1 )int [][] d1 = new int [d0.length ][8 ];for (int d2 = 0 ; d2 < d0.length ; d2++) {int d3 = d0[d2];for (int d4 = 0 ; d4 < d1[d2].length ; d4++) {int d5 = ((d2 ^ d4) | -(d2 ^ d4)) >>> 31 ;int d6 = (d5 ^ 1 ) & d3;int d7 = ((d4 ^ 0 ) | -(d4 ^ 0 )) >>> 31 ;int d8 = ((d4 ^ 1 ) | -(d4 ^ 1 )) >>> 31 ;int d9 = ((d4 ^ 2 ) | -(d4 ^ 2 )) >>> 31 ;int e0 = ((d4 ^ 3 ) | -(d4 ^ 3 )) >>> 31 ;1 ) | (d8 ^ 1 )) | (((d9 ^ 1 ) | (e0 ^ 1 )) & 0 ));char [][] e1 = {char ) ((23 * 4 ) + 10 ),char ) ((25 * 4 ) + 5 ),char ) ((30 * 4 ) + 2 ),char ) ((40 * 3 ) + 2 )char ) (200 - 102 ),char ) (100 + 17 ),char ) (61 * 2 ),char ) ((11 * 11 ) + 1 )char ) (90 + 23 ),char ) (120 - 9 ),char ) (60 * 2 ),char ) (114 )char ) (50 + 59 ),char ) (200 - 95 ),char ) (230 / 2 ),char ) (116 )char ) (100 + 8 ),char ) (110 + 7 ),char ) (228 / 2 ),char ) (101 )char ) (55 * 2 ),char ) (111 ),char ) (112 ),char ) (101 )char ) (99 ),char ) (97 ),char ) (103 ),char ) (101 )char ) (109 ),char ) (97 ),char ) (122 ),char ) (101 )int [][] e2 = new int [d1.length ][4 ];for (int e3 = 0 ; e3 < d1.length ; e3++) {int e4 = 0 ;for (int e5 = 0 ; e5 < d1[e3].length ; e5++) {int e6 = ((e3 ^ 0 ) | -(e3 ^ 0 )) >>> 31 ;int e7 = ((e3 ^ 1 ) | -(e3 ^ 1 )) >>> 31 ;int e8 = ((e3 ^ 2 ) | -(e3 ^ 2 )) >>> 31 ;int e9 = ((e3 ^ 3 ) | -(e3 ^ 3 )) >>> 31 ;0 ] = e4 & (e6 ^ 1 );1 ] = e4 & (e7 ^ 1 );2 ] = (e4 & (e8 ^ 1 )) & 0 ;3 ] = (e4 & (e9 ^ 1 )) & 0 ;int [][] f0 = new int [e2.length ][e1.length ];for (int f1 = 0 ; f1 < f0.length ; f1++) {for (int f2 = 0 ; f2 < f0[f1].length ; f2++) {int f3 = e2[f1][0 ] | e2[f1][1 ] | e2[f1][2 ] | e2[f1][3 ];int f4 = ((f1 ^ 0 ) | -(f1 ^ 0 )) >>> 31 ;int f5 = ((f1 ^ 1 ) | -(f1 ^ 1 )) >>> 31 ;int f6 = ((f2 ^ 0 ) | -(f2 ^ 0 )) >>> 31 ;int f7 = ((f2 ^ 1 ) | -(f2 ^ 1 )) >>> 31 ;int f8 = ((f4 ^ 1 ) & (f6 ^ 1 )) | ((f5 ^ 1 ) & (f7 ^ 1 ));int f9 = ((f1 + i) ^ (i + f1));int g0 = (((f9 | -f9) >>> 31 ) ^ 1 );new StringBuilder();for (int g2 = 0 ; g2 < f0.length ; g2++) {for (int g3 = 0 ; g3 < f0[g2].length ; g3++) {int g4 = f0[g2][g3];for (int g5 = 0 ; g5 < e1[g3].length * g4; g5++) {int g6 = g5 ^ g5;int g7 = g6 + g5;int g8 = (g7 ^ g6) ^ g6;char g9 = (char ) (e1[g3][g8] ^ g6);new StringBuilder().append(i).toString();new String[16 ];0 ] = h1;1 ] = h0;2 ] = h1.substring(0 );3 ] = new StringBuilder(h0).reverse().reverse().toString();4 ] = h1 + "" ;5 ] = h0 + "" ;6 ] = new StringBuilder(h1).reverse().reverse().toString();7 ] = new StringBuilder(h0 + "" ).substring(0 );8 ] = h2[0 ].concat("" );9 ] = h2[1 ].concat("" );10 ] = h2[2 ].replace("" , "" ).length() == 0 ? h2[2 ] : h2[2 ];11 ] = h2[3 ].replace("" , "" ).length() == 0 ? h2[3 ] : h2[3 ];12 ] = new StringBuilder().append(h2[4 ]).toString();13 ] = new StringBuilder().append(h2[5 ]).toString();14 ] = h2[6 ].substring(0 );15 ] = h2[7 ].substring(0 );int h3 = h0.length();int h4 = (h3 | -h3) >>> 31 ;int h5 = h4;1 );31 );1 ) & 0 );int h6 = h5 & 1 ;int h7 = ((h6 ^ 0 ) | -(h6 ^ 0 )) >>> 31 ;int h8 = ((h6 ^ 1 ) | -(h6 ^ 1 )) >>> 31 ;int h9 = ((h7 ^ 1 ) * 0 ) + ((h8 ^ 1 ) * 1 );int i0 = h9 | (((h9 ^ h6) | -(h9 ^ h6)) >>> 31 & 0 );return h2[i0];
これを解析して作成されたJavaDoc
/** * 入力値に応じて文字列を返す。 * * <p> このメソッド内のコードだけを読む限り、まず入力値 { @code i} から複数の中間値を作成し、 * その後、複数の整数候補を持つ配列を用意している。候補値には、実質的に * { @code 3} 、 { @code 5} 、 { @code 4} 、 { @code 7} 、 { @code 9} 、 { @code 11} 、 { @code 13} 、 * { @code 17} 、 { @code 19} 、 { @code 23} 、 { @code 29} 、 { @code 31} に相当する値が * 含まれているように見える。 </p> * * <p> 各候補値について、 { @code i / 候補値 * 候補値 } が元の { @code i} と一致するかどうかを、 * XOR 、ビット OR 、符号なし右シフトなどを使って判定しているように見える。 * この処理は、入力値 { @code i} が各候補値で割り切れるかどうかを調べているように読める。 </p> * * <p> 判定結果は 2 次元配列に格納され、その後、複数の集約変数や中間状態配列へ変換される。 * このうち、入力値 { @code i} が { @code 3} で割り切れるかどうかに対応する値と、 * { @code 5} で割り切れるかどうかに対応する値が、最終的な文字列生成に影響しているように見える。 </p> * * <p> { @code 4} 、 { @code 7} 、 { @code 9} 、 { @code 11} 、 { @code 13} 、 { @code 17} などに * 関連する判定結果も作成されているが、それらの多くは同じ値同士の XOR 、 { @code & 0} 、 * 常に { @code 0} になるように見える中間値との AND などによって、最終結果に影響しないように * 無効化されているように見える。ただし、このメソッドだけを読んだ段階では、それらすべてが完全に * 無意味であるとまでは断定しにくい。 </p> * * <p> 文字列生成には、複数の 4 文字候補を持つ { @code char} の 2 次元配列が使われている。 * 先頭の候補は文字コード計算により { @code "fizz"} に相当する文字列を表し、 * 2 番目の候補は { @code "buzz"} に相当する文字列を表しているように読める。 * それ以外にも複数の候補文字列が定義されているが、後続のマスク処理や選択処理を見る限り、 * 実際に最終結果へ追加される経路には到達しない、または到達しにくいように制御されているように見える。 </p> * * <p> 文字列を構築するまでに、複数の 2 次元配列、状態配列、マスク値、インデックス判定が使われる。 * これらの処理では、インデックスが特定値と一致するかどうかをビット演算で判定し、 * どの文字列候補を追加するかを間接的に決めているように見える。 * 実質的には、入力値が { @code 3} に関する条件を満たす場合に先頭の文字列候補を追加し、 * { @code 5} に関する条件を満たす場合に 2 番目の文字列候補を追加しているように読める。 </p> * * <p> ループ内には、 { @code (x + i) ^ (i + x)} のように、加算の交換法則により常に * { @code 0} になるように見える式や、同じ値同士の XOR によって常に { @code 0} になるように * 見える式が含まれている。これらは、実質的には結果を変化させない固定的な値として使われているように * 見えるが、コード上は解析対象の中間状態を増やしている。 </p> * * <p> 最終的に構築された文字列が空でない場合は、その文字列またはそれと同等に見える候補を返す。 * 構築された文字列が空の場合は、入力値 { @code i} を文字列化したもの、またはそれと同等に見える * 候補を返すように見える。返却候補は 16 要素の配列に格納されており、 * { @code substring} 、文字列連結、二重 { @code reverse} 、 { @code concat} などによって、 * 実質的に同じ値を持つ候補が複数作られているように見える。 </p> * * <p> 総合すると、このメソッドは、入力値 { @code i} が { @code 3} で割り切れる場合に * { @code "fizz"} に相当する文字列を追加し、 { @code 5} で割り切れる場合に * { @code "buzz"} に相当する文字列を追加しているように見える。 * 両方の条件を満たす場合は、それらを順に連結した文字列を返すように見える。 * どちらの条件にも該当しない場合は、入力値 { @code i} の文字列表現を返すように見える。 </p> * * <p> ただし、このメソッドには、結果に影響しないように見える候補値、文字列候補、状態配列、 * 2 次元配列、ビット演算、到達しないように見える経路、同等値を作る可逆変換が多数含まれている。 * そのため、このメソッドだけを読んだ段階では、すべての中間値や候補経路の意味を完全に断定することは * 難しい。 </p> * * @param i 判定対象の整数 * @return 条件に応じて組み立てられた文字列、または { @code i} の文字列表現 */